

做过Web应用、API接口、小程序后端、SaaS平台、电商交易、内容平台的团队,大概率都经历过这种场景:
- CDN已经上了,静态资源缓存命中率不错,但源站压力还是很大;
- 有些请求明明可以做简单处理,却必须回源,增加延迟;
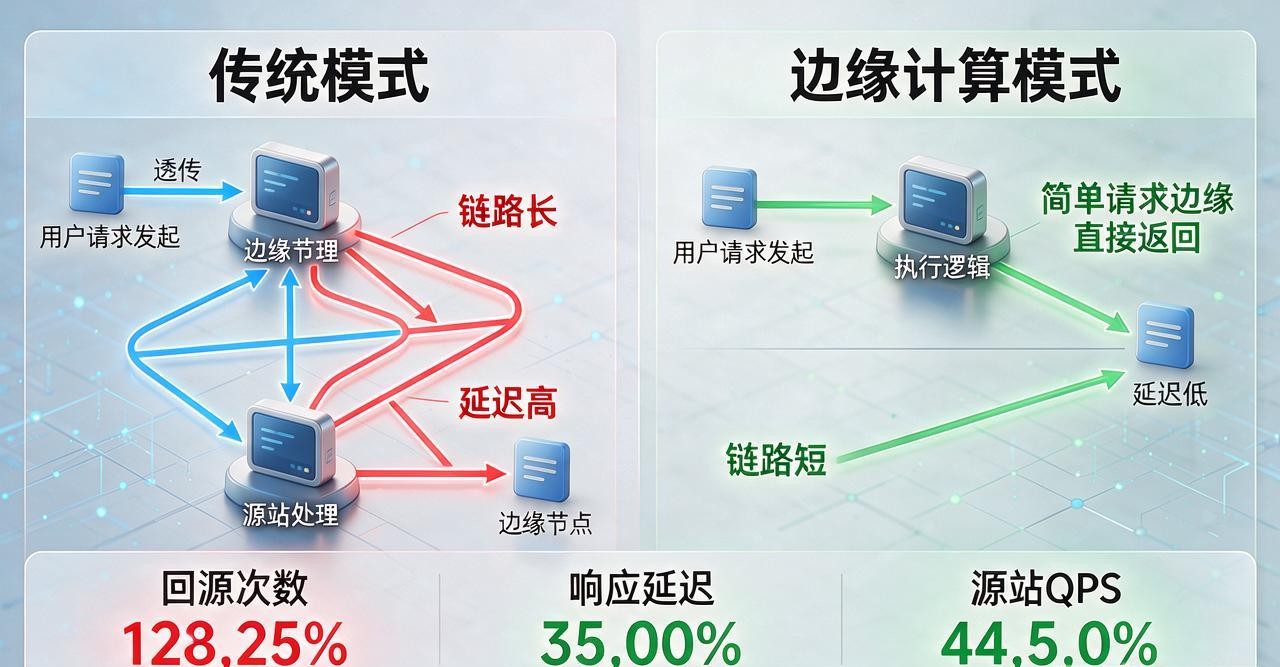
- 用户请求要经过"客户端 → CDN边缘 → 源站 → CDN边缘 → 客户端",链路长、延迟高;
- 某些业务逻辑想在边缘侧就近执行,但不知道怎么做;
- 源站带宽成本高,很多请求其实可以在边缘侧直接响应;
- 想降低首屏延迟、接口响应时间,但传统CDN只能缓存静态资源,帮不上忙。
这些问题背后,指向同一个核心:传统CDN只能"缓存和转发",无法在边缘侧执行逻辑。
传统CDN的工作方式很简单:用户请求到达边缘节点,如果缓存命中就直接返回,没命中就回源站取数据。这种模式对静态资源很有效,但对需要动态处理的请求无能为力。
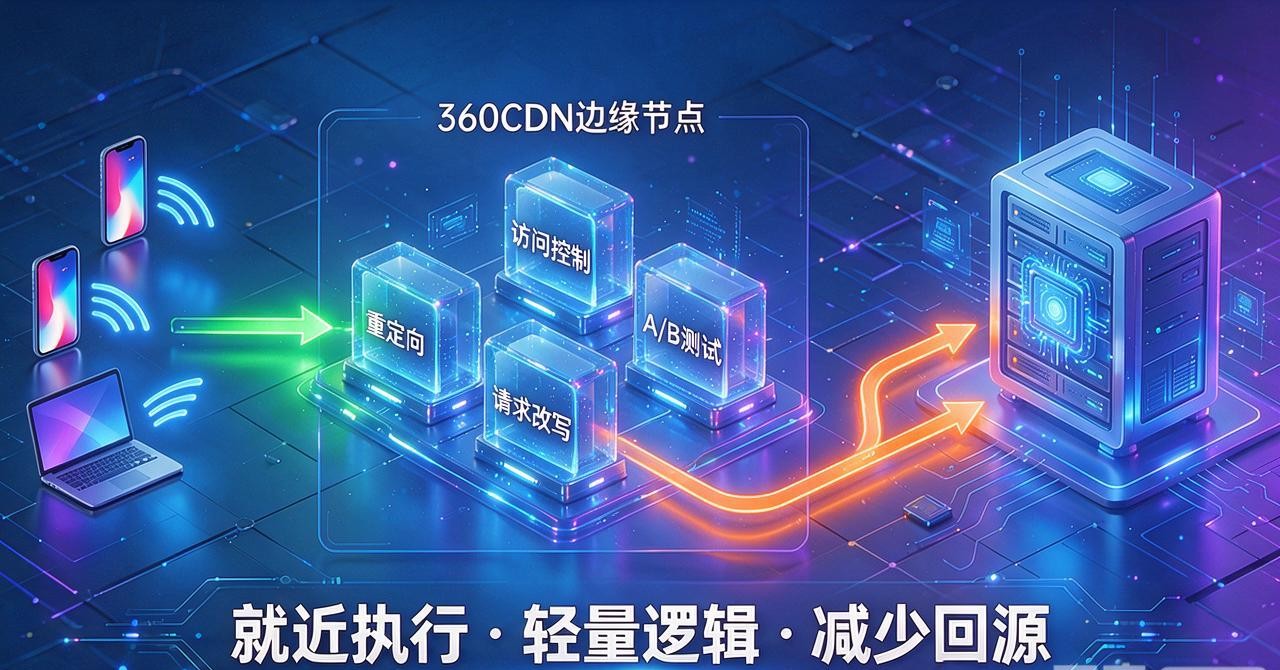
为了帮企业把计算能力推到离用户更近的地方,360CDN正式推出面向Web业务、API接口和实时交互场景的 边缘计算 / Edge Routine方案。核心思路是:把部分业务逻辑放到CDN边缘节点执行,让请求在离用户最近的节点完成处理,减少回源次数、降低响应延迟、减轻源站压力。
传统CDN的边界:能缓存,但不能"思考"
传统CDN的核心能力是缓存和分发。
它的典型工作流程是:
- 用户发起请求;
- 请求到达最近的CDN边缘节点;
- 边缘节点检查缓存是否命中;
- 命中则直接返回缓存内容;
- 未命中则回源站获取数据,再返回给用户。
这个流程对静态资源(图片、JS、CSS、视频、文档)非常有效,因为静态资源内容固定,缓存后可以反复使用。
但现代Web业务里,大量请求是"缓存不了但又很简单"的:
- 请求头改写(添加/删除/修改Header);
- URL重写和重定向;
- 简单的A/B测试分流;
- 请求参数校验;
- 黑白名单拦截;
- 简单的JSON拼接;
- 地域/运营商判断;
- 防盗链校验;
- 简单的聚合响应;
- 灰度发布流量调度。
这些逻辑如果都回源站处理,会带来几个问题:
- 延迟高:请求必须往返源站,链路长;
- 源站压力大:大量简单请求占用源站资源;
- 带宽成本高:回源流量增加;
- 扩展性差:源站要处理更多并发请求。
边缘计算的核心价值,就是把这些"简单但必须处理"的逻辑放到边缘节点执行,让请求在离用户最近的地方完成响应。
360CDN边缘计算怎么做?"就近执行 + 轻量逻辑 + 减少回源"
360CDN的边缘计算 / Edge Routine方案,不是要把源站搬到边缘,而是把适合在边缘执行的轻量逻辑放到CDN节点上运行。
1. 就近执行:请求在边缘节点处理,不用回源
传统模式下,请求必须回源站处理,边缘节点只是"中转站"。
边缘计算模式下,边缘节点变成"处理站":
- 用户请求到达边缘节点;
- 边缘节点执行预配置的逻辑代码;
- 如果逻辑能在边缘完成,直接返回响应;
- 如果需要源站数据,再按需回源;
- 响应从边缘节点直接返回给用户。
这样做的好处是:
- 减少回源次数,降低源站压力;
- 响应路径更短,延迟更低;
- 边缘节点分布式执行,天然具备高并发能力;
- 用户就近获得响应,体验更好。
2. 轻量逻辑:适合在边缘执行的业务场景
边缘计算不是万能的,它适合执行轻量、低延迟、无状态或弱状态的逻辑。
典型适用场景包括:
- 请求改写:修改URL、添加/删除请求头、参数转换;
- 重定向:HTTP到HTTPS跳转、旧域名到新域名跳转、地域重定向;
- 访问控制:IP黑白名单、UA拦截、Referer校验、简单鉴权;
- A/B测试:根据Cookie、Header、地域分流到不同后端;
- 灰度发布:按用户ID、地域、版本分流到灰度环境;
- 聚合响应:多个简单请求合并成一个响应;
- 自定义错误页:404、503等错误在边缘直接返回友好页面;
- 简单数据拼接:根据请求参数生成简单JSON响应;
- 日志增强:在边缘侧记录请求日志,减少源站日志压力。
这些逻辑共同特点是:计算量小、不需要复杂数据库查询、不需要长期状态存储、对延迟敏感。
3. 减少回源:把"能边缘处理的"留在边缘
边缘计算最直接的效果就是减少回源。
举个例子:
- 传统模式:用户访问
https://api.example.com/redirect,请求回源站,源站判断地域后返回302重定向,再返回给用户。链路:用户 → 边缘 → 源站 → 边缘 → 用户。 - 边缘计算模式:用户访问同一个URL,边缘节点直接根据用户IP判断地域,返回302重定向。链路:用户 → 边缘 → 用户。
回源次数从1次变成0次,延迟明显降低。
再比如:
- 传统模式:每个API请求都要回源站做简单的参数校验,源站返回校验结果。
- 边缘计算模式:边缘节点直接校验参数,不合法的请求直接在边缘返回错误响应,合法请求才回源。
这样源站只需要处理真正有效的请求,压力大幅下降。
哪些业务场景最适合边缘计算?
边缘计算不是所有业务都必须上,但在以下场景中,效果往往比较突出:
表格
共同特点是:有大量轻量请求需要处理,回源成本高,对延迟敏感。
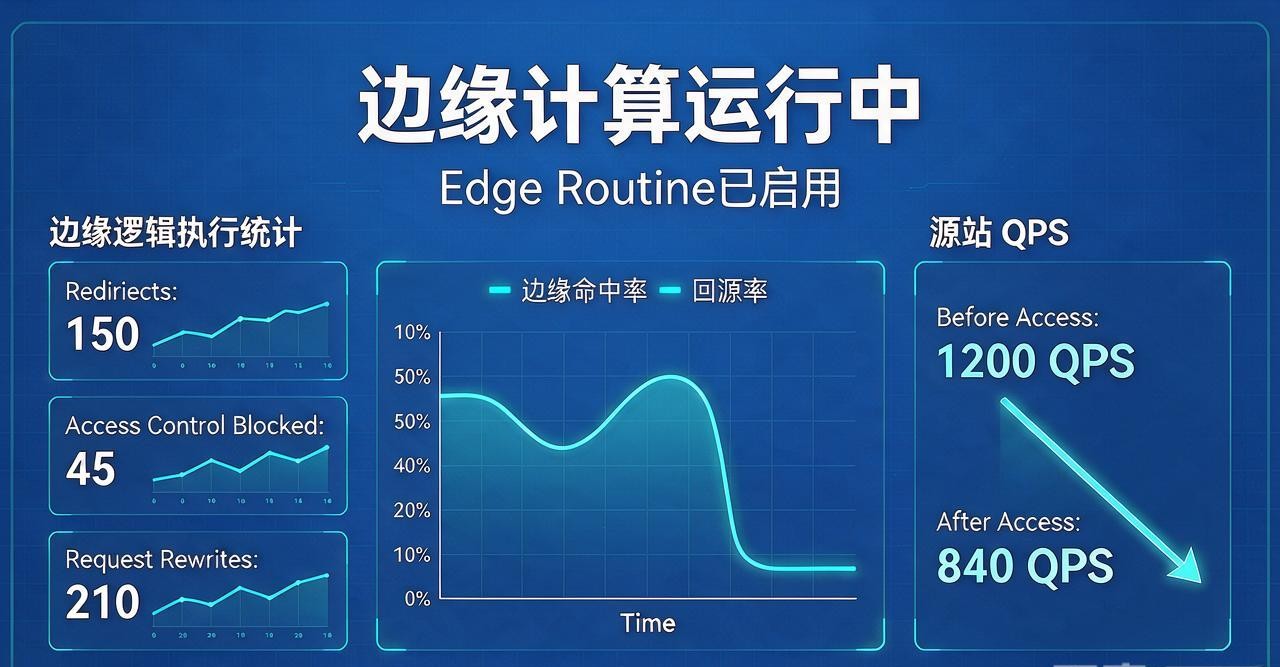
实战反馈:某内容平台重定向和访问控制逻辑下沉边缘,源站QPS下降30%
前段时间,一个内容平台客户遇到一个典型问题:他们的网站有大量重定向请求(HTTP→HTTPS、旧域名→新域名、移动端→PC端),还有IP黑白名单、UA拦截等访问控制逻辑,这些逻辑全部在源站处理。
运维团队发现:
- 每天有大量请求只是做重定向,却必须回源站;
- 访问控制逻辑在源站执行,占用不少CPU资源;
- 高峰期源站QPS很高,但很多请求其实可以在边缘处理;
- 跨地域用户访问重定向接口时,延迟较高。
接入360CDN边缘计算 / Edge Routine方案后,他们做了以下调整:
- 把HTTP→HTTPS重定向逻辑放到边缘节点执行;
- 把旧域名→新域名重定向逻辑放到边缘节点执行;
- 把移动端/PC端判断和跳转逻辑放到边缘节点执行;
- 把IP黑白名单、UA拦截等访问控制逻辑放到边缘节点执行;
- 对简单参数校验类请求,在边缘直接返回错误响应,不合法请求不回源。
接入后,他们反馈比较明显:
- 重定向类请求不再回源,源站QPS下降约30%;
- 访问控制类请求在边缘拦截,源站压力进一步降低;
- 用户端重定向响应速度提升,页面跳转更快;
- 跨地域用户的跳转延迟明显改善;
- 源站带宽成本下降;
- 运维团队可以在边缘侧快速调整重定向和访问控制规则,不用频繁发布源站代码。
他们技术负责人后来总结:"以前觉得重定向和访问控制很简单,放源站处理就行。后来发现这些请求量很大,累积起来对源站压力不小。下沉到边缘后,源站轻松了很多,用户体验也更好。"
⚠️ 掏心窝子的避坑指南
给准备上边缘计算的兄弟们提几个实战建议,都是很容易踩的坑。
1. 先梳理哪些逻辑适合下沉边缘,别把复杂业务搬到边缘
边缘计算适合轻量、无状态、低延迟的逻辑,不适合复杂业务。
建议先梳理清楚:
- 哪些逻辑是轻量计算(重定向、改写、校验、拦截);
- 哪些逻辑需要数据库查询(不适合边缘);
- 哪些逻辑需要长期状态存储(不适合边缘);
- 哪些逻辑涉及复杂业务规则(可能不适合边缘);
- 哪些逻辑对延迟敏感且请求量大(优先下沉)。
边缘计算是"源站的补充",不是"源站的替代"。
2. 边缘逻辑要保持无状态或弱状态
边缘节点是分布式部署的,用户请求可能被调度到不同的边缘节点。
如果边缘逻辑依赖长期状态(如用户Session、购物车数据、订单状态),可能出现:
- 同一用户不同请求落到不同节点,状态不一致;
- 状态同步复杂,增加系统复杂度;
- 节点故障时状态丢失。
建议:
- 边缘逻辑尽量无状态;
- 需要状态的场景,通过Cookie、Token、URL参数传递;
- 复杂状态数据依然放在源站或集中式存储;
- 边缘侧只做轻量判断和转发。
3. 边缘代码要轻量,避免复杂计算
边缘节点的计算资源是有限的,不适合执行复杂逻辑。
建议:
- 边缘代码保持轻量,避免复杂循环和大量计算;
- 避免在边缘侧执行数据库查询;
- 避免在边缘侧调用外部API(增加延迟和依赖);
- 边缘代码要做性能测试,确保响应时间可控;
- 复杂业务逻辑依然放在源站。
边缘计算的核心是"轻量就近处理",不是"把源站搬过去"。
4. 灰度发布和A/B测试要注意分流一致性
如果边缘逻辑涉及灰度发布或A/B测试,分流一致性很重要。
建议:
- 按用户ID、Cookie、Token等稳定标识分流;
- 避免按随机数分流,导致同一用户不同请求落到不同版本;
- 分流规则要清晰可追溯;
- 灰度发布要有回滚机制;
- 测试阶段充分验证分流逻辑。
分流不一致会导致用户体验混乱,排查困难。
5. 边缘逻辑要有监控和日志
边缘代码运行在分布式节点上,调试和排查比源站更复杂。
建议:
- 边缘逻辑要有日志记录;
- 关键操作要有监控指标;
- 异常请求要有告警;
- 边缘代码版本要有管理;
- 上线前在测试环境充分验证。
边缘计算虽然轻量,但运维规范不能放松。
如果你的业务也面临 重定向请求量大、访问控制逻辑多、源站QPS高、接口延迟敏感、想降低回源成本 这些问题,可以把适合边缘执行的轻量逻辑接入360CDN边缘计算 / Edge Routine方案,先做一轮逻辑梳理和灰度测试。
了解更多边缘计算的实战玩法,请访问:360cdn.com