

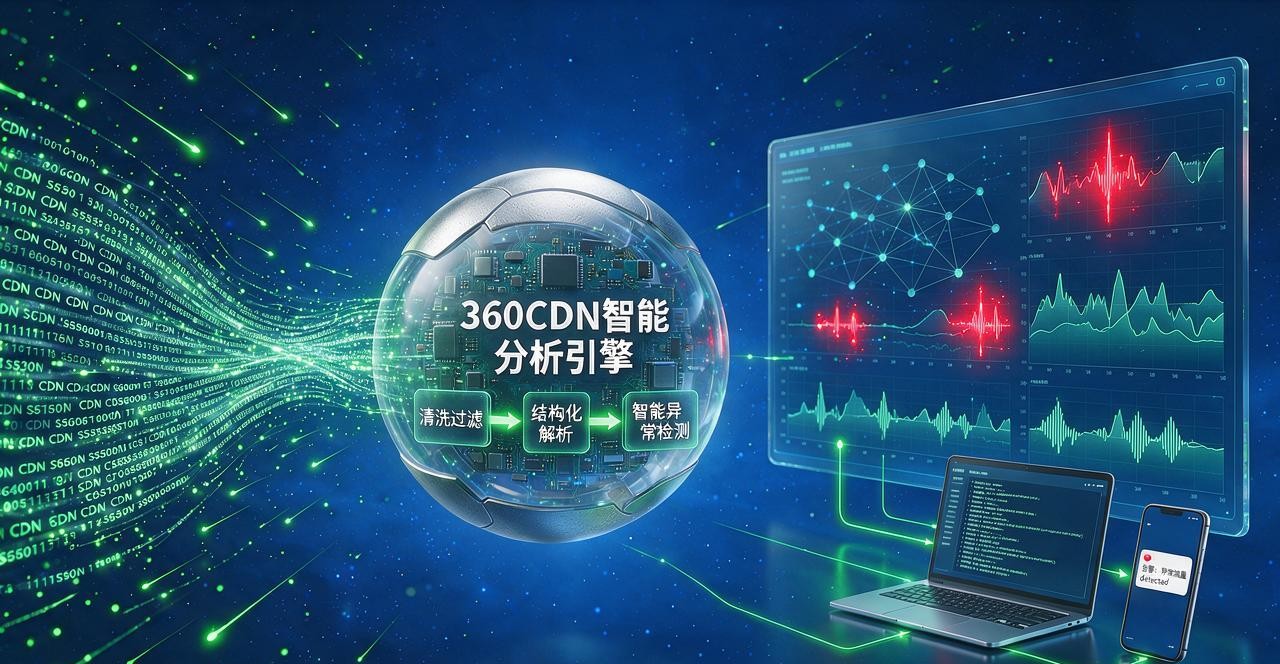
做过CDN运维的兄弟肯定深有体会:每天产生的访问日志动辄几十GB甚至上百GB,堆在对象存储里吃灰,根本没人看。等到源站被打挂、用户大面积报错、老板打电话来问"怎么回事"的时候,你才手忙脚乱地去翻日志排查问题,一翻就是大半天。这真不是你运维能力不行,而是传统"日志靠存不靠用"的模式,在海量数据面前已经彻底失效了。
为了帮企业彻底告别"日志堆积如山、故障后知后觉"的被动局面,360CDN这周正式放出了专门针对CDN日志全生命周期管理的"日志分析与智能监控方案"。说白了,就是把每天几十GB的原始日志,实时清洗、结构化、智能分析,自动生成可视化报表和异常告警,让你在故障发生的第一时间就知道"哪里出了问题、影响了多少用户、怎么快速修复"。
别把日志当"存档",实时分析才是正解
很多企业的日志管理还停留在"每天把日志文件下载到本地,用grep/awk手动翻"的阶段。但问题是,CDN每天产生的日志量极其庞大,一个中等规模的站点每天就能产生几十GB的日志,包含几亿条记录。靠人工翻日志,别说实时发现问题了,连昨天的日志都翻不完。
360CDN这套方案直接走了"实时流式分析"的路子:边缘节点产生的每一条日志,会在毫秒级内被推送到分析引擎,经过自动清洗(过滤爬虫、机器人等无效请求)、结构化解析(提取状态码、响应时间、客户端IP、请求URL等关键字段)、聚合统计后,实时生成可视化报表。你打开控制台就能看到当前各域名的请求量、命中率、回源率、错误率、响应时间分布等核心指标,完全不需要手动处理任何日志文件。
故障发生后才知道?"智能异常检测"让你提前5分钟收到告警
传统监控的痛点是"阈值告警"——你得自己设一个阈值(比如错误率超过5%就告警),但很多故障在初期并不会触发固定阈值,等你发现的时候已经大面积影响了。
360CDN在这里用了一招"智能异常检测"。系统会基于历史数据自动学习每个域名的正常流量模式(比如工作日和周末的流量差异、白天和晚上的请求特征),然后实时对比当前数据与历史基线。一旦检测到异常偏离(比如某个域名的5xx错误率突然从0.1%飙升到3%,虽然还没到你设的5%阈值,但已经明显偏离正常基线),系统会在秒级内触发告警,并通过短信、邮件、钉钉、企业微信等多渠道推送给你。从异常发生到你收到告警,整个过程不超过5分钟。
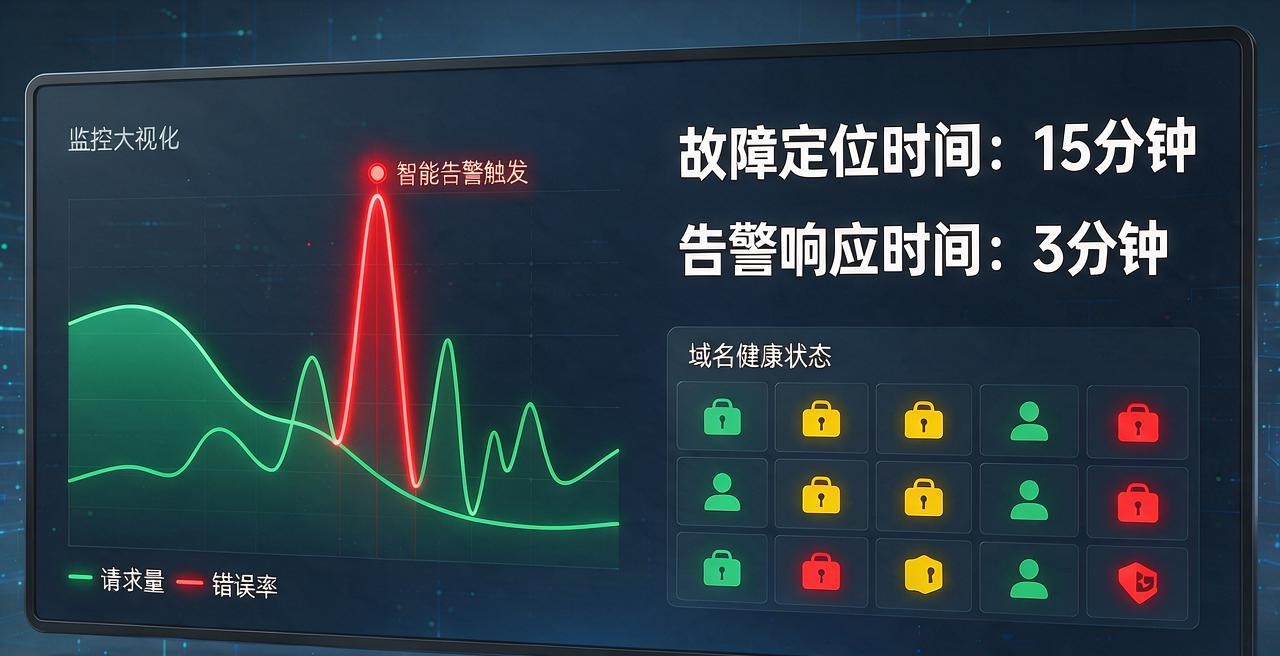
实战反馈:某资讯平台故障定位时间从4小时缩短到15分钟,月均故障影响用户数下降92%
上个月,国内有个做资讯平台的客户找过来。他们的痛点极其要命:业务覆盖全国,每天产生80GB的CDN日志,全靠运维团队手动下载分析。上个月一次源站抖动导致大面积502错误,运维团队花了4个小时才从日志里定位到问题根因,期间超过50万用户受到影响。
接了360CDN的日志分析与智能监控方案后,效果立竿见影。他们运维负责人昨天特意发微信说:"现在日志全自动实时分析,控制台一眼就能看到所有核心指标。上周又出现了一次类似的源站抖动,系统在3分钟内就推送了告警,我们15分钟内就定位到问题并完成切换,影响用户数从50万降到了不到5000。"
⚠️ 掏心窝子的避坑指南
最后,给准备上日志分析与智能监控的兄弟们提两个醒,这都是真金白银砸出来的教训:
- 日志字段一定要按需采集,别全量采集:很多团队图省事,把所有日志字段全量采集。但实际上,像请求头里的User-Agent、Cookie等字段,在大多数分析场景下根本用不到,全量采集只会白白增加存储和分析成本。一定要根据实际分析需求,只采集关键字段(状态码、响应时间、客户端IP、请求URL、回源状态等),非必要字段可以按需开启。
- 告警规则千万别"一刀切",要分级分域配置:不同域名的重要程度不一样,核心业务域名(比如支付页、登录页)的告警阈值应该比非核心域名(比如静态资源域名)更严格。一定要按域名、按指标分级配置告警规则,否则要么告警太多导致"告警疲劳",要么关键告警被淹没在海量噪音里。
如果你也被"日志堆积如山、故障后知后觉"折磨得够呛,欢迎来360CDN聊聊,我们直接帮你把现有日志接入智能分析平台。
了解更多日志分析与智能监控的硬核玩法,请访问:360cdn.com